MLOps e LLMOps: o que é preciso para manter IA funcionando bem depois do lançamento
A disciplina operacional que sustenta sistemas de IA em produção: versionamento, avaliação contínua, monitoramento de degradação, controle de custo e resposta a incidentes.
Existe um momento específico em que projetos de inteligência artificial deixam de ser interessantes e passam a ser trabalhosos: o dia seguinte ao lançamento. O sistema está no ar, funcionando bem, e a partir dali começa a corrida silenciosa contra a degradação.
Modelos de linguagem são atualizados pelos provedores e mudam de comportamento. Documentos são revisados e a base envelhece. O negócio muda de regra e o sistema continua aplicando a antiga. O padrão de uso evolui e o custo sobe. Alguém edita um prompt e ninguém registra.
MLOps e LLMOps são o nome que se dá à disciplina de lidar com isso. Este artigo trata do conjunto mínimo de práticas que uma empresa de médio porte precisa para manter sistemas de IA confiáveis ao longo do tempo — sem montar uma estrutura de empresa de tecnologia.
A diferença entre MLOps e LLMOps
Vale distinguir, porque os desafios não são os mesmos.
MLOps trata de modelos treinados pela própria empresa sobre seus dados: previsão de demanda, risco, classificação. Os problemas centrais são reprodutibilidade do treinamento, versionamento de dados e modelos, e desvio estatístico — quando a realidade muda e o modelo treinado no passado perde precisão.
LLMOps trata de sistemas construídos sobre modelos de linguagem de terceiros. Aqui não há treinamento próprio, mas surgem problemas específicos: o comportamento do modelo muda sem aviso, a qualidade da saída é difícil de medir objetivamente, o custo é variável por uso e a base de conhecimento precisa de manutenção contínua.
A maioria das empresas de médio porte hoje precisa muito mais de LLMOps do que de MLOps. Mas as práticas se sobrepõem bastante, e as fundamentais são comuns.
Fundação 1 — Versionar tudo o que influencia o comportamento
Este é o ponto de partida e o que mais falta em implantações reais.
Em um sistema de IA, o comportamento é determinado por vários elementos, e todos precisam ser versionados e rastreáveis:
- O modelo e sua versão exata, incluindo parâmetros de geração.
- Os prompts, com histórico de alterações e autor.
- A configuração de recuperação: estratégia de divisão de documentos, número de trechos, critérios de filtro.
- A base de conhecimento e seu estado em cada momento.
- As regras de negócio codificadas na orquestração.
- O conjunto de avaliação.
O sintoma clássico de ausência disso: o sistema começa a responder pior e ninguém consegue determinar o que mudou. Prompts editados diretamente em produção, sem registro, são a causa mais frequente.
A solução não é sofisticada: prompts e configurações vivem em repositório de código, passam por revisão como qualquer alteração, e a promoção para produção é registrada. Custa pouco e resolve a maior parte dos casos.
Fundação 2 — Avaliação contínua, não pontual
O conjunto de avaliação — aquele com 100 a 300 casos reais com resposta esperada validada por especialista — não é um artefato de implantação. É infraestrutura permanente.
Ele precisa ser executado automaticamente em quatro situações: antes de qualquer alteração ir para produção; quando o provedor anuncia nova versão do modelo; periodicamente, mesmo sem mudanças, para detectar variação silenciosa; e após atualizações relevantes da base de conhecimento.
O resultado precisa ser comparável ao longo do tempo, com histórico. Uma queda de 4 pontos percentuais na acurácia entre uma execução e a seguinte é exatamente o tipo de sinal que passa despercebido sem esse acompanhamento.
O conjunto precisa crescer. Toda vez que o sistema erra em produção de forma relevante, aquele caso entra no conjunto com a resposta correta. Em alguns meses, o conjunto passa a representar bem os casos difíceis reais — e isso é um ativo valioso da empresa, independente de qualquer fornecedor.
Um cuidado metodológico: separe uma parte dos casos e não os use para ajustar o sistema. Se todo o conjunto é usado para otimização, o desempenho medido fica otimista e não representa casos novos.
Fundação 3 — Observabilidade
Registro completo de cada interação, com o suficiente para reconstituir e diagnosticar:
Identificação do usuário e do contexto, entrada recebida, documentos ou dados consultados, versão do modelo e do prompt, saída gerada, quantidade de contexto consumido, latência, custo, ação executada e feedback do usuário quando houver.
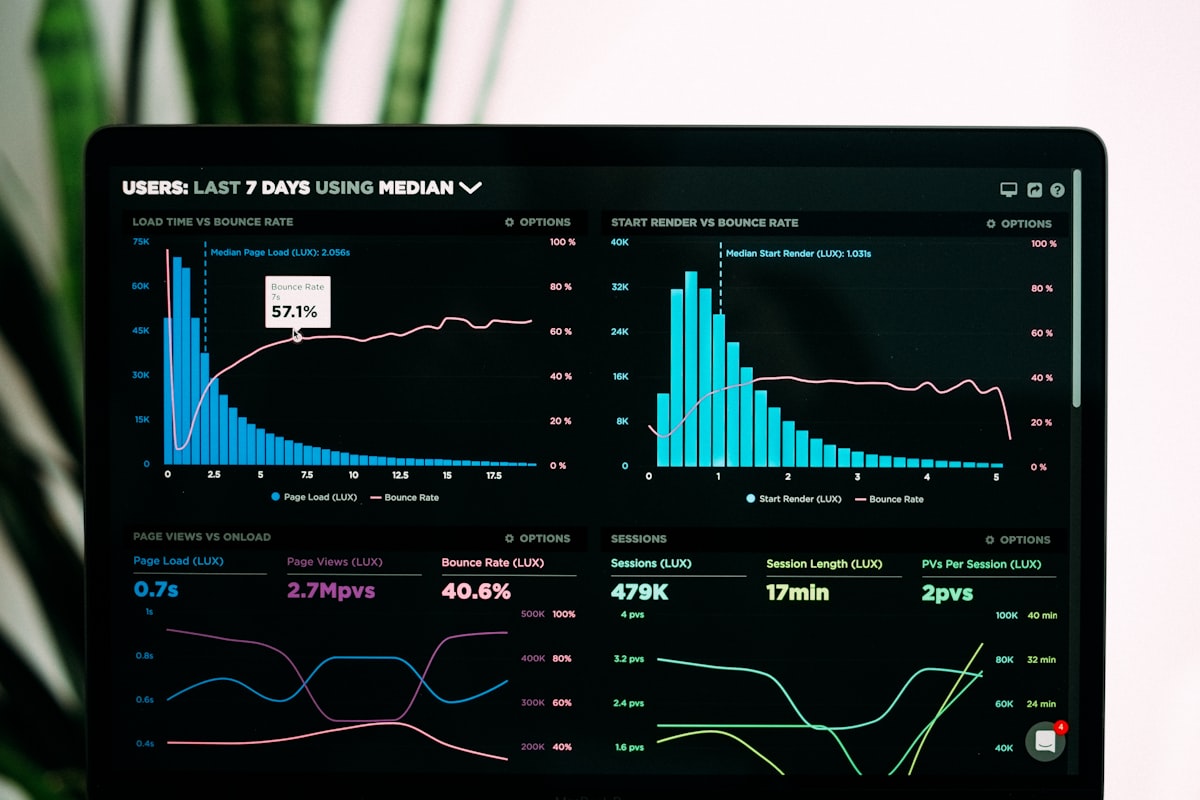
Sobre isso, construa métricas operacionais acompanhadas continuamente:
| Métrica | O que indica quando piora |
|---|---|
| Taxa de resolução sem escalonamento | Cobertura caindo ou base desatualizada |
| Avaliação negativa do usuário | Degradação de qualidade percebida |
| Latência no percentil 95 | Problema de infraestrutura ou contexto crescendo |
| Custo médio por operação | Uso ineficiente, retentativas, escopo crescendo |
| Volume de contexto por chamada | Recuperação selecionando mal |
| Taxa de recusa do sistema | Base com lacunas ou instrução restritiva demais |
O custo por operação merece destaque: é o indicador mais sensível a problemas silenciosos. Ele deveria cair com o tempo, à medida que o sistema é otimizado. Quando sobe sem aumento correspondente de valor entregue, há algo errado.
Fundação 4 — Detectar degradação
Sistemas de IA não falham com erro visível. Eles pioram gradualmente, o que é bem mais difícil de perceber.
As causas típicas e como detectá-las:
Mudança de versão do modelo pelo provedor. Fixe a versão sempre que possível, acompanhe os anúncios de descontinuação e execute o conjunto de avaliação antes de aceitar qualquer migração. Migrações automáticas são a causa mais comum de mudança inesperada de comportamento.
Envelhecimento da base de conhecimento. Monitore a idade média dos documentos consultados nas respostas. Se o sistema responde predominantemente com material de dois anos atrás, a base parou de ser mantida.
Mudança no padrão de perguntas. Os usuários passam a perguntar sobre temas que a base não cobre. Detecta-se pela taxa de recusa e pelo aumento de escalonamento em categorias específicas.
Mudança de regra de negócio. O sistema continua aplicando o critério antigo. Só se detecta com revisão periódica junto às áreas — nenhuma métrica automática pega isso.
Desvio de dados, no caso de modelos preditivos: a distribuição das entradas muda em relação ao período de treinamento. Compare as distribuições periodicamente.
Fundação 5 — Gestão de custo
Diferente de software tradicional, sistemas de IA têm custo marginal por uso, o que torna o crescimento de consumo um risco operacional.
Controles que funcionam:
Limites por usuário e por aplicação, para que um uso anômalo ou um defeito não gere conta inesperada.
Alertas de projeção, disparados quando a tendência do mês indica estouro — não quando o estouro já ocorreu.
Cache de respostas frequentes. Em bases corporativas, a concentração de perguntas repetidas é alta e o ganho é imediato.
Seleção de modelo por tarefa. Modelo econômico para classificação e reformulação; modelo mais capaz apenas na geração final. Reduções expressivas de custo sem perda perceptível de qualidade.
Controle de contexto. É o principal componente do custo. Recuperação bem calibrada envia menos trechos e melhores.
Fundação 6 — Resposta a incidentes específicos de IA
O plano de resposta da empresa precisa contemplar cenários que não existiam antes.
Resposta incorreta com impacto. Procedimento: identificar o escopo — quantos usuários receberam informação semelhante, consultando os registros —, corrigir a causa, comunicar os afetados e adicionar o caso ao conjunto de avaliação.
Exposição indevida de informação. Verificar imediatamente o filtro de permissão na recuperação, levantar o alcance pelos registros e tratar como incidente de segurança, com as obrigações de comunicação aplicáveis.
Ação indevida de agente. Acionar o interruptor de emergência, reverter o que for reversível, e revisar os limites de autonomia antes de religar.
Indisponibilidade do provedor. Ter um caminho degradado definido: modelo alternativo configurado, ou uma mensagem clara ao usuário com o procedimento manual, em vez de falha silenciosa.
Cada um desses cenários deve ter responsável e procedimento escritos antes de acontecer.
A pergunta que define maturidade operacional: se o sistema começar a responder pior hoje, em quanto tempo você perceberia — e como saberia o que mudou?
Como promover mudanças com segurança
Uma dúvida prática recorrente: como alterar um sistema de IA em produção sem arriscar quebrar o que funciona?
O processo que recomendamos tem cinco passos e é deliberadamente simples, para que seja efetivamente seguido.
Passo 1 — Reproduzir o problema. Antes de alterar qualquer coisa, transforme a queixa em casos concretos. "O assistente está respondendo mal sobre férias" precisa virar cinco perguntas específicas com a resposta correta. Sem isso, a correção é feita no escuro e ninguém consegue confirmar que funcionou.
Passo 2 — Adicionar ao conjunto de avaliação. Os novos casos entram antes da correção, não depois. Assim é possível demonstrar que o problema existia, que foi resolvido, e garantir que não volte.
Passo 3 — Alterar uma coisa por vez. Mudança de prompt, de estratégia de recuperação e de modelo simultaneamente torna impossível saber o que produziu o efeito — e, pior, se uma melhorou enquanto outra piorou.
Passo 4 — Executar o conjunto completo, não só os casos novos. Este é o passo mais pulado e o mais importante. Ajustes de prompt para corrigir um comportamento frequentemente degradam outro. Sem a execução completa, você troca um problema conhecido por um desconhecido.
Passo 5 — Promover gradualmente. Direcione uma fração do tráfego real para a nova versão e compare as métricas operacionais por alguns dias antes de completar a migração. Para sistemas com poucos usuários, um grupo piloto cumpre o mesmo papel.
E mantenha sempre a possibilidade de reverter rapidamente para a versão anterior. Como prompts e configurações estão versionados, isso é uma mudança de referência, não uma reconstrução.
Um detalhe operacional que vale registrar: estabeleça uma janela em que mudanças não são promovidas — normalmente sexta-feira à tarde e vésperas de períodos críticos do negócio. Sistemas de IA falham de forma sutil, e é preciso haver gente disponível para perceber.
O mínimo viável para empresa de médio porte
Não é necessário replicar a estrutura de uma empresa de tecnologia. O conjunto proporcional:
- Prompts e configurações em repositório versionado, com revisão antes da promoção.
- Conjunto de avaliação executado automaticamente a cada mudança e mensalmente por rotina.
- Registro completo de interações, com retenção definida.
- Painel com cinco a sete métricas operacionais, revisado mensalmente.
- Versão do modelo fixada, com processo definido para avaliar migrações.
- Dono do conteúdo nomeado, com revisão trimestral da base junto às áreas.
- Alertas de custo por projeção.
- Procedimentos de incidente escritos para os quatro cenários acima.
Isso é implementável em poucas semanas por um time pequeno e cobre a esmagadora maioria dos problemas reais.
O custo de não fazer
Vale explicitar o que acontece na ausência dessas práticas, porque o custo é real e chega tarde.
O sistema entra no ar bem avaliado. Ao longo de seis a doze meses, a base envelhece, o modelo é atualizado, os prompts são ajustados sem registro e o padrão de uso muda. A qualidade cai gradualmente. Os usuários param de confiar e voltam ao processo anterior — sem reclamar formalmente, apenas usando menos.
Um ano depois, alguém pergunta qual foi o retorno do projeto. Não há dados para responder, o uso é baixo e a conclusão organizacional é que "IA não funcionou aqui" — o que contamina as iniciativas seguintes por anos.
A degradação silenciosa é o maior risco de projetos de IA corporativa. E é inteiramente evitável com disciplina operacional modesta.
Quem faz esse trabalho
Uma preocupação legítima ao ler esta lista é imaginar que ela exige um time dedicado. Não exige, desde que as responsabilidades sejam atribuídas explicitamente.
Na prática, o esforço recorrente de manter um sistema de IA corporativo em boas condições costuma ficar entre quatro e oito horas mensais de trabalho técnico, mais uma reunião de revisão de uma hora com as áreas envolvidas. O que consome tempo não é a operação em si — é a ausência de rotina, que transforma cada verificação em uma investigação do zero.
A distribuição que funciona: o responsável técnico executa o conjunto de avaliação, acompanha as métricas e trata as alterações; o dono do conteúdo revisa a base e valida as mudanças de regra de negócio; e a reunião mensal junta os dois com o patrocinador para decidir sobre o que apareceu.
O ponto crítico é que essas horas precisam estar protegidas na agenda. Manutenção de IA compete com demanda operacional urgente e perde sempre — até o dia em que o sistema degradou o suficiente para virar, ele próprio, a urgência.
Conclusão
Colocar IA em produção é a metade fácil. Mantê-la funcionando bem exige versionamento, avaliação contínua, observabilidade, detecção de degradação, controle de custo e procedimentos de incidente.
Nada disso é sofisticado ou caro. É disciplina — o mesmo tipo de disciplina que já se aplica a qualquer sistema crítico, adaptada às formas particulares pelas quais sistemas de IA falham: gradualmente, silenciosamente e sem mensagem de erro.
A BHELP.tech implanta essa camada operacional junto com o sistema, e transfere sua operação para o time interno com documentação e treinamento. Porque o valor de um projeto de IA não se mede no lançamento — mede-se no terceiro ano, quando ele ainda está funcionando bem.